


RAG Cara Elegan Biar Chatbot Berhenti Mengarang Jawaban
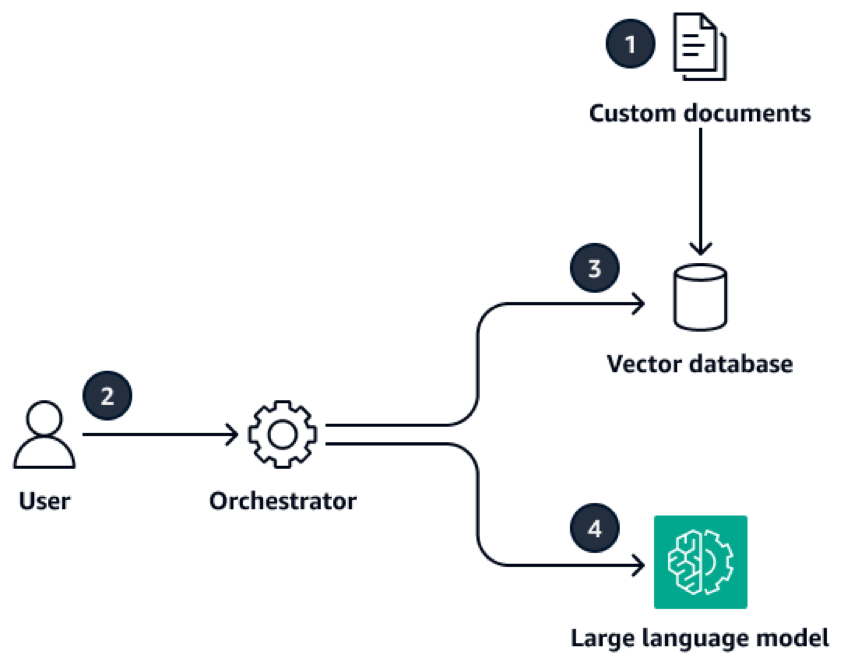 Gambar 1. Alur RAG dari query, pencarian semantik di dokumen, sampai jawaban LLM (sumber: https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/what-is-rag.html)
Hai, Software Engineers! Pernahkah Anda bertanya ke chatbot kampus soal jadwal ujian, lalu jawabannya terdengar meyakinkan padahal salah total. Fenomena mengarang jawaban ini disebut halusinasi, dan pemicunya sederhana. Model bahasa besar atau LLM menjawab dari hafalan data training yang statis, jadi saat tidak tahu jawabannya, model tetap menjawab dengan percaya diri. AWS menganalogikannya seperti pegawai baru yang terlalu antusias dan selalu menjawab setiap pertanyaan dengan keyakinan penuh. Di sinilah Retrieval-Augmented Generation atau RAG masuk sebagai pola arsitektur yang elegan, karena chatbot mengambil referensi dulu sebelum menjawab.
RAG Memberi Model Catatan Contekan yang Sah
RAG adalah proses mengoptimalkan output LLM dengan merujuk ke knowledge base otoritatif di luar data training, tanpa perlu melatih ulang model. Panduan AWS merumuskannya dalam empat langkah yang sederhana. Pertama, tim menyiapkan dokumen internal, mengubah teksnya menjadi representasi numerik yang disebut embedding, lalu menyimpannya di vector database. Kedua, pengguna mengirim pertanyaan dalam bahasa natural. Ketiga, komponen orchestrator mencari potongan dokumen yang relevan di vector database dan menempelkannya ke prompt sebagai konteks. Keempat, LLM menyusun jawaban dengan bekal konteks tersebut, seperti yang tampak pada Gambar 1.
Makalah yang memperkenalkan istilah ini ditulis Lewis dan koleganya pada 2020 dengan menggabungkan memori parametrik berupa model seq2seq dan memori nonparametrik berupa indeks vektor Wikipedia. Pada masanya, pendekatan ini mencapai hasil terbaik di tiga tugas tanya jawab terbuka dan menghasilkan bahasa yang lebih spesifik dan faktual. Pelajaran pentingnya bertahan sampai sekarang, yaitu pengetahuan faktual lebih baik disimpan di luar model agar mudah diperbarui dan ditelusuri sumbernya. Tim pengembang pada dasarnya memisahkan dua urusan, yaitu model merangkai bahasa, sedangkan kebenaran faktual dititipkan ke dokumen yang bisa diaudit.
Pipeline RAG dari Dokumen Mentah sampai Jawaban
Tahap paling menentukan terjadi sebelum ada pertanyaan masuk, yaitu saat dokumen diubah menjadi indeks yang bisa dicari. Dokumentasi LangChain merumuskannya dalam empat langkah, yaitu load, split, embed, dan store, seperti terlihat pada Gambar 2. Dokumen dimuat dari berbagai sumber, lalu dipotong menjadi potongan kecil yang disebut chunk, karena potongan besar sulit dicari dan boros memakai jendela konteks model. Setiap chunk diubah menjadi vektor numerik oleh model embedding, lalu disimpan bersama teks dan metadatanya di vector store.
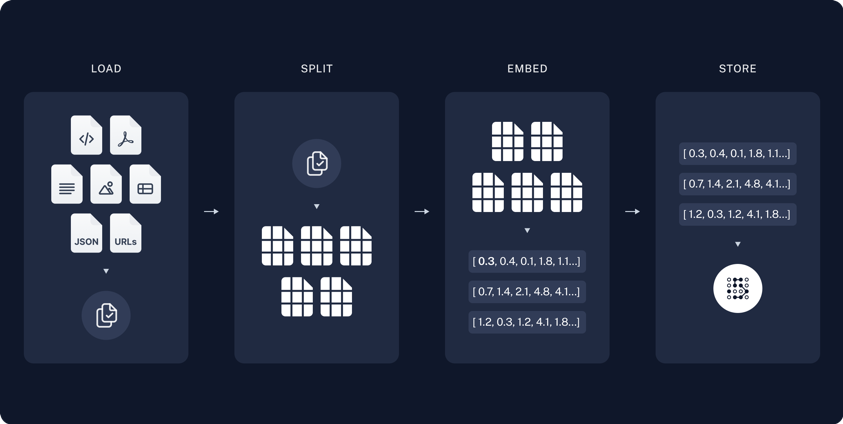 Gambar 2. Tahap indexing RAG, dari pemuatan dokumen, pemotongan, embedding, sampai penyimpanan vektor (sumber: https://docs.langchain.com/oss/python/deepagents/rag)
Bayangkan Anda membangun asisten tanya jawab untuk dokumen kampus, misalnya panduan akademik, SOP pengajuan cuti, dan FAQ beasiswa. Dokumen PDF itu dipecah per bagian, diubah jadi embedding, dan disimpan di indeks vektor. Saat mahasiswa bertanya soal syarat cuti, sistem mengubah pertanyaan menjadi vektor juga, mencari potongan paling mirip, lalu menempelkannya ke prompt sebelum LLM menjawab. Contoh serupa dipakai AWS untuk chatbot kepegawaian yang menarik dokumen kebijakan cuti sekaligus riwayat cuti karyawan. Jawaban yang keluar bisa menyertakan sitasi ke dokumen sumber, sehingga mahasiswa bisa mengecek sendiri dan kepercayaan terhadap sistem ikut naik.
Kapan Cukup Prompt, Kapan Butuh RAG, Kapan Latih Ulang
Tidak semua masalah butuh RAG, dan tabel di bawah merangkum keputusan praktisnya. Prompt biasa cukup saat jawabannya mengandalkan kemampuan umum model, misalnya merangkum teks atau mengubah gaya bahasa. RAG menjadi pilihan saat jawaban harus merujuk dokumen organisasi yang tidak ada di data training dan butuh sitasi yang bisa diverifikasi. Latih ulang atau fine-tuning baru masuk akal saat Anda ingin mengubah perilaku model secara permanen, dan biayanya paling mahal karena butuh komputasi besar serta data latih yang disiapkan serius.
| Pendekatan | Kapan dipakai | Biaya dan usaha |
| Prompt saja | Tugas umum tanpa pengetahuan internal, jawaban tidak butuh sitasi | Murah, langsung jalan |
| RAG | Jawaban merujuk dokumen internal yang berubah dan butuh sumber terverifikasi | Sedang, bangun pipeline chunking, embedding, dan indeks vektor |
| Fine-tuning | Mengubah perilaku atau gaya model secara permanen | Mahal, butuh data latih dan komputasi besar |
Batas RAG yang Wajib Anda Rancang Sejak Awal
RAG bukan sulap yang otomatis membuat jawaban benar, karena kualitas jawabannya hanya sebaik dokumen dan proses retrieval di belakangnya. Kalau dokumennya basi atau pencarian mengambil konteks yang salah, LLM akan merangkai jawaban salah dengan bahasa yang tetap meyakinkan. Karena itu data eksternal wajib diperbarui, baik lewat proses real-time maupun batch berkala, dan sistem produksi butuh guardrail agar query, konteks, dan jawaban bebas dari halusinasi serta bias. Anda juga perlu mengukur apakah potongan yang diambil memang relevan sebelum menyalahkan modelnya.
Satu pemikiran ke depan untuk Anda, yaitu anggap RAG sebagai pekerjaan rekayasa data, bukan sekadar memanggil API model. Keputusan soal strategi chunking, kualitas dokumen sumber, dan pengukuran relevansi retrieval lebih menentukan daripada sekadar mengganti model yang lebih besar. Mulailah dari satu tumpukan dokumen yang kecil tapi bersih, misalnya FAQ satu unit kerja, lalu ukur dan perluas perlahan. Chatbot yang menjawab dengan sitasi ke dokumen nyata akan selalu lebih dipercaya daripada chatbot yang hanya terdengar pintar.
Referensi
- AWS. What is Retrieval-Augmented Generation? https://aws.amazon.com/what-is/retrieval-augmented-generation/
- AWS Prescriptive Guidance. What is RAG? https://docs.aws.amazon.com/prescriptive-guidance/latest/retrieval-augmented-generation-options/what-is-rag.html
- LangChain. RAG (Deep Agents). https://docs.langchain.com/oss/python/deepagents/rag
- Lewis dkk. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. https://arxiv.org/abs/2005.11401
Comments :