


Menetapkan Latency SLO untuk Agen AI agar Pengguna Tidak Menunggu Lama
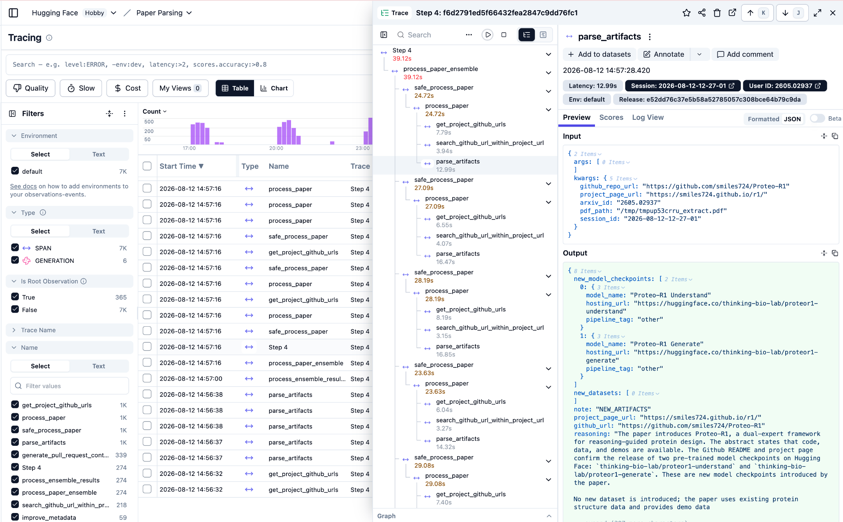 Gambar 1. Tampilan trace alur multi-step agen AI pada antarmuka observabilitas Langfuse yang memetakan durasi tiap pemanggilan model dan eksekusi tool (sumber: https://langfuse.com/docs/observability/overview)
Hai, Software Engineers! Bayangkan Anda meminta asisten cerdas menganalisis berkas log server. Layar hanya memunculkan animasi memuat (loading) tanpa kepastian apakah komputasi masih berjalan atau sistem sudah mati diam-diam (silent failure). Situasi tanpa kepastian ini membuat pengguna frustrasi dan terus memuat ulang halaman. Masalah tersebut menegaskan bahwa sistem cerdas tidak cukup berstatus aktif bebas galat, melainkan membutuhkan durasi respons yang terukur.
Membedah Anatomi Latensi pada Alur Kerja Agen AI
Alur kerja agen cerdas melibatkan penalaran berulang (reasoning loops) yang lebih kompleks daripada aplikasi web biasa. Dalam satu putaran tugas, sistem memproses konteks, merencanakan aksi, memanggil fungsi eksternal (tool calling), lalu menyusun jawaban. Tiap langkah menyumbang jeda waktu yang terakumulasi sehingga total durasi interaksi mudah membengkak. Gambar 1 menunjukkan bagaimana platform observabilitas memetakan durasi tiap simpul (span) agar tim pengembang dapat mengisolasi titik hambatan.
Mengukur performa agen membutuhkan tiga indikator inferensi utama. Pertama adalah Time to First Token (TTFT), yakni jeda sejak pengiriman instruksi hingga token pertama muncul di layar. Kedua adalah Time Per Output Token (TPOT), yaitu kecepatan rata-rata pembuatan setiap token berikutnya. Pengujian Databricks mencatat bahwa TPOT sebesar 100 ms menghasilkan aliran sekitar 10 token per detik per pengguna, melampaui rata-rata kecepatan baca manusia. Indikator ketiga adalah latensi eksekusi tools, seperti query API eksternal atau basis data vektor.
Tiga Taktik Memangkas Waktu Tunggu Pengguna
Taktik pertama untuk memangkas waktu tunggu adalah menerapkan transmisi bertahap (streaming) melalui Server-Sent Events (SSE). Protokol ini langsung mengalirkan pecahan kata begitu dibuat model tanpa menunggu seluruh jawaban selesai di server. Dokumentasi resmi Anthropic menjelaskan bahwa transmisi bertahap menjaga koneksi tetap aktif sekaligus mencegah kendala HTTP timeout pada respon panjang. Pengguna merasa sistem tanggap karena baris awal jawaban langsung terbaca dalam hitungan detik.
Pendekatan kedua berfokus pada eksekusi fungsi eksternal secara serentak. Saat agen perlu memeriksa data dari beberapa sumber sekaligus, pemanggilan API secara paralel memotong antrean waktu tunggu kumulatif. Selain itu, panduan teknis OpenAI mencatat bahwa memangkas 50% panjang token instruksi atau batasan keluaran dapat memangkas sekitar 50% total latensi respons model secara efektif. Pengurangan token ini meringankan beban server dan mempercepat aliran respons kembali ke pengguna.
Strategi ketiga adalah menetapkan batas waktu tegas (timeout) yang dipadukan dengan pengalihan otomatis (fallback) menuju model yang lebih ringkas. Model penalaran besar memiliki logika kuat, namun beban memorinya kerap memperpanjang durasi inferensi. Gambar 2 memperlihatkan kurva korelasi antara throughput dan latensi, di mana beban kerja yang melebihi kapasitas perangkat keras menaikkan latensi tajam tanpa menambah hasil kerja. Pengalihan otomatis ke model yang lebih kecil saat batas waktu terlampaui menjaga jawaban tetap sampai dalam batas toleransi wajar.
Merancang Alokasi Budget Latensi dan Menetapkan SLO
Mewujudkan layanan agen yang konsisten memerlukan perancangan Service Level Objective (SLO) berbasis anggaran waktu (latency budget). Setiap subsistem agen wajib memiliki plafon durasi maksimum sejak awal arsitektur dibuat. Pengembang perlu memantau persentil ke-95 (P95) ketimbang rata-rata biasa demi mendeteksi lonjakan waktu tunggu terburuk yang dirasakan pengguna. Tabel di bawah merangkum alokasi anggaran latensi dan strategi optimasi pada setiap komponen alur kerja agen cerdas:
| Komponen Alur Kerja | Metrik Kunci | Porsi Budget Waktu | Strategi Utama Optimasi |
| Validasi Input dan Guardrail | Latensi komputasi lokal | Minimal | Model klasifikasi ringan atau aturan lokal |
| Perencanaan Awal dan Tool Planning | Time to First Token (TTFT) | Prioritas respons awal | Prompt caching dan streaming SSE |
| Eksekusi Tool Eksternal | Latensi I/O dan durasi API | Batas timeout ketat | Pemanggilan independen secara paralel |
| Sintesis Jawaban Akhir | Time Per Output Token (TPOT) | Sesuai volume teks | Batas maksimal token keluaran |
Pengukuran berbasis telemetri nyata wajib mendahului pengumuman janji SLO kepada pengguna maupun manajemen produk. Riset Databricks menemukan bahwa perbedaan infrastruktur komputasi awan dapat memicu variasi latensi hingga 2 kali lipat pada kartu grafis yang tampak setara. Tim pengembang perlu mengumpulkan data riil selama beberapa siklus operasional sebelum meresmikan standar batas waktu respons. Disiplin dalam mengukur metrik dan menjaga anggaran latensi akan melahirkan agen cerdas yang tidak hanya andal, melainkan juga tanggap melayani pengguna.
Referensi
- OpenAI. Latency Optimization Guide. https://platform.openai.com/docs/guides/latency-optimization
- Langfuse. Tracing and Observability Overview. https://langfuse.com/docs/observability/overview
- Databricks. LLM Inference Performance Engineering: Best Practices. https://www.databricks.com/blog/llm-inference-performance-engineering-best-practices
- Anthropic. Streaming Messages with the Claude API. https://docs.anthropic.com/en/docs/build-with-claude/streaming
Comments :