


Versioning Prompt dan Regression Test: Cara Mengunci Kualitas Output AI
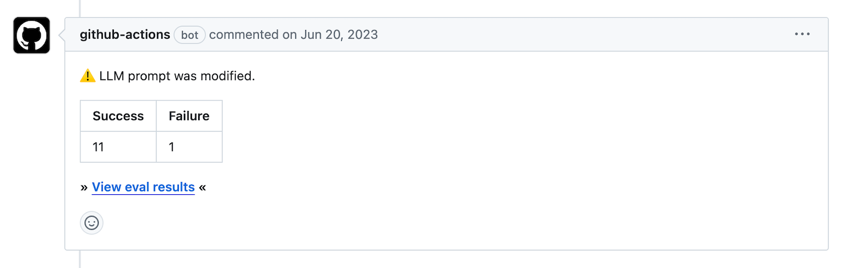 Gambar 1. Hasil evaluasi otomatis promptfoo pada Pull Request GitHub Actions yang membandingkan performa prompt sebelum dan sesudah perubahan (sumber: https://www.promptfoo.dev/docs/integrations/github-action/)
Hai, Software Engineers! Bayangkan Anda sedang memperbaiki instruksi bot layanan pelanggan agar pembukanya lebih ramah. Anda mengubah satu kalimat di system prompt, mengujinya dua kali di playground, lalu langsung meluncurkannya ke production. Beberapa jam kemudian, tim operasional panik karena bot mulai mengarang kupon diskon fiktif dan merusak format output sistem tiket. Perubahan kecil pada satu kalimat ternyata mengacaukan skenario lain tanpa terdeteksi sebelumnya.
Memperlakukan Prompt Sebagai Kode Software
Dalam pengembangan aplikasi berbasis model bahasa besar, prompt bukan lagi teks percakapan biasa. Rekayasa perangkat lunak menempatkan teks instruksi ini sebagai logika bisnis penentu perilaku sistem. Ketika pengembang membiarkan prompt tersimpan di variabel statis tanpa riwayat revisi, pelacakan akar masalah menjadi membingungkan. Praktik rekayasa perangkat lunak menuntut perubahan instruksi disimpan dalam sistem kendali versi seperti Git agar tim dapat membandingkan teks, meninjau lewat pull request, dan melakukan rollback kapan saja.
Platform manajemen modern seperti Langfuse menawarkan pemisahan artefak instruksi dari biner aplikasi. Alur kerja ini memberi label lingkungan seperti staging atau production pada setiap rilis instruksi yang teruji. Jika versi terbaru memicu kendala, pengembang dapat mengembalikan label ke versi stabil tanpa perlu deploy ulang seluruh aplikasi. Alur kerja terstruktur ini terangkum pada Gambar 2, yang memperlihatkan bagaimana revisi instruksi bergerak dari repositori Git menuju pengujian hingga siap diluncurkan.
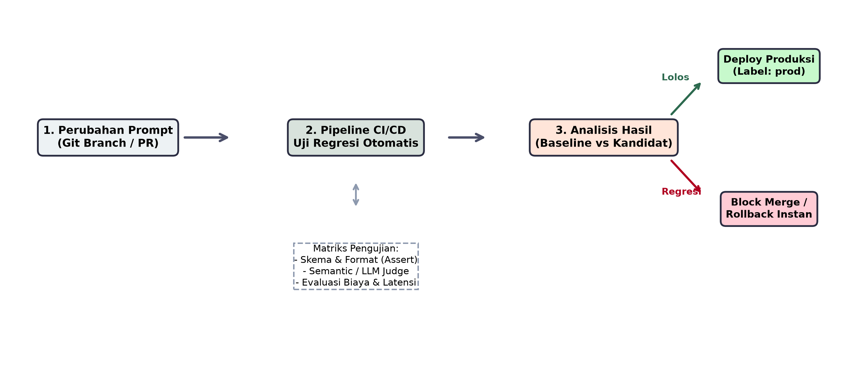 Gambar 2. Ilustrasi penulis alur versioning prompt dan regression test dari revisi di Git sampai deployment produksi (sumber: https://langfuse.com/docs/prompts)
Eval Set Sebagai Regression Test Otomatis
Tantangan terbesar dalam menguji aplikasi berbasis AI adalah sifat keluarannya yang non-deterministik. Pengujian perangkat lunak tradisional yang mengandalkan pencocokan teks persis kerap gagal menangani variasi jawaban model bahasa. LangSmith mencatat bahwa pengembang memerlukan evaluasi offline terstruktur sebelum rilis guna membedah standar kualitas keluaran secara objektif. Tanpa himpunan data uji yang konsisten, tim hanya mengandalkan intuisi saat menilai apakah instruksi baru bekerja lebih baik daripada versi sebelumnya.
Solusi untuk masalah ini adalah menyusun himpunan data emas (golden dataset) yang berfungsi sebagai regression test suite. Himpunan data ini memuat puluhan contoh masukan nyata, kasus batas, kegagalan masa lalu, dan kriteria keberhasilan yang terukur. Praktisi rekayasa AI Hamel Husain menyarankan hierarki evaluasi berjenjang, dimulai dari asersi unit cepat pada setiap perubahan instruksi sebelum melangkah ke penilaian model. Tim dapat mengintegrasikan alat pengujian ke alur integrasi berkelanjutan GitHub Actions, sebagaimana terlihat pada Gambar 1. Setiap pull request yang memodifikasi berkas instruksi akan otomatis memicu pengujian regresi dan menampilkan tabel perbandingan langsung di kolom komentar.
Komponen Pengujian dan Batasan Evaluasi AI
Pengujian regresi instruksi yang menyeluruh memeriksa beberapa dimensi penting aplikasi secara bersamaan. Tabel berikut merangkum empat dimensi utama yang perlu diuji setiap kali pengembang memperbarui prompt:
| Dimensi Pengujian | Yang Diperiksa | Metode Pengujian | Contoh Kegagalan |
| Format dan Skema | Struktur JSON, tipe data, dan kunci wajib | Asersi kode deterministik | Parsing galat akibat kurung kurawal hilang |
| Ketepatan Semantik | Pemenuhan instruksi pengguna | Model bahasa sebagai juri (LLM-as-a-judge) | Asisten melewatkan poin keluhan pelanggan |
| Keamanan dan Batasan | Kebocoran data rahasia dan pencegahan halusinasi | Evaluasi berbasis aturan dan filter kata kunci | Chatbot menjanjikan diskon di luar kebijakan |
| Efisiensi Operasional | Jumlah token terpakai dan waktu respons | Metrik pemantauan telemetri | Biaya membengkak karena kalimat terlalu panjang |
Meskipun otomatisasi pengujian mempercepat siklus rilis, pengembang perlu menyadari batasan evaluasi otomatis. Penilai berbasis model bahasa dapat membawa bias tersendiri dan terkadang gagal menangkap konteks domain bisnis yang rumit. Dokumentasi OpenAI mengingatkan pentingnya merancang evaluasi yang mewakili pola penggunaan nyata tanpa bergantung sepenuhnya pada metrik tunggal. Tim pengembang tetap membutuhkan pemeriksaan berkala oleh penilai manusia untuk mengkalibrasi ketepatan uji otomatis dan memperbarui kumpulan data uji secara berkala.
Menjaga Keandalan dari Baris Instruksi
Memperlakukan instruksi model bahasa sebagai artefak rekayasa perangkat lunak mengubah cara tim membangun produk kecerdasan buatan. Kombinasi kendali versi yang rapi dan pengujian regresi otomatis memberi kepastian bagi developer saat melakukan iterasi produk. Anda tidak perlu cemas menghadapi perubahan perilaku yang tak terduga setiap kali memperbarui kalimat instruksi. Ketika disiplin pengujian kode diterapkan pada rekayasa prompt, aplikasi kecerdasan buatan Anda akan tumbuh stabil dan siap melayani pengguna di lingkungan produksi.
Referensi
- Promptfoo. GitHub Action Integration. https://www.promptfoo.dev/docs/integrations/github-action/
- Langfuse. Prompt Management. https://langfuse.com/docs/prompts
- LangSmith. Evaluation Concepts. https://docs.smith.langchain.com/evaluation
- Husain, Hamel. Your AI Product Needs Evals. https://hamel.dev/blog/posts/evals/
- OpenAI. Evals Guide. https://platform.openai.com/docs/guides/evals
Comments :