


Token Cost Engineering: Strategi Cerdas Mengendalikan Tagihan API Model AI
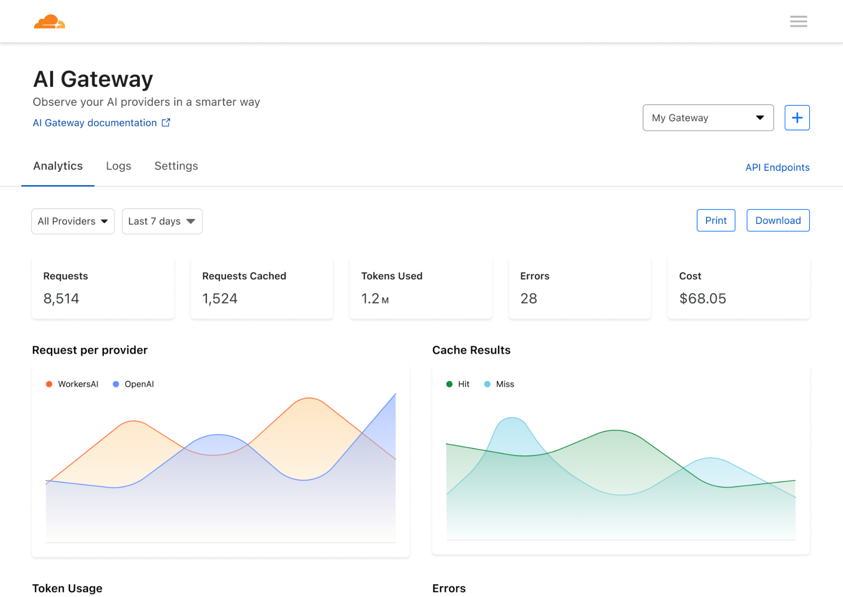 Gambar 1. Dasbor metrik analitik dan pelacakan biaya inferensi pada Cloudflare AI Gateway. (sumber: https://blog.cloudflare.com/announcing-ai-gateway/)
Hai, Software Engineers! Bayangkan skenario yang kerap dihadapi tim pemula saat merilis aplikasi kecerdasan buatan ke publik. Antusiasme mendadak runtuh ketika tagihan bulanan antarmuka pemrograman aplikasi (API) membengkak di luar perkiraan. Setiap kali pengguna mengirim sapaan sederhana, sistem memanggil model bahasa besar (LLM) tercanggih beserta puluhan ribu token riwayat. Pengalaman ini menunjukkan bahwa membangun aplikasi AI generatif menuntut kecakapan merekayasa efisiensi token.
Triase Cerdas Melalui Model Routing
Kekeliruan umum dalam perancangan aplikasi cerdas adalah menyamakan bobot komputasi seluruh permintaan. Kueri ringan seperti ekstraksi kata kunci sering dikirim ke model mahal seperti Claude Opus atau GPT-4o. Tindakan ini ibarat menyewa mobil formula hanya untuk mengantar surat ke seberang gang. Di sinilah teknik model routing hadir sebagai pintu triase yang efisien.
Melalui pustaka seperti LiteLLM Router, sistem mengevaluasi kompleksitas permintaan sebelum memilih model tujuan. Kueri ringan diarahkan ke model mini berbiaya hemat, sedangkan penalaran rumit diserahkan ke model berkapasitas besar. LiteLLM juga menyediakan fitur fallback otomatis ke penyedia alternatif ketika terjadi gangguan atau batas frekuensi (rate limit). Alur inferensi pun berjalan stabil dengan biaya terukur, seperti terlihat pada Gambar 1 mengenai visibilitas metrik operasional gateway.
Menghemat Input dengan Prompt Caching
Beban biaya token terbesar dalam arsitektur modern umumnya berpusat pada konteks awal (input token), melampaui teks jawaban (output token). Pada sistem percakapan atau Retrieval-Augmented Generation (RAG), instruksi sistem (system prompt), definisi alat, dan dokumen rujukan statis bisa menyentuh ribuan token berulang. Tanpa optimasi, penyedia model AI menghitung ulang dan menagih pemrosesan teks panjang tersebut di setiap giliran obrolan.
Teknologi prompt caching memecahkan masalah ini dengan menyimpan representasi komputasi awalan teks (prefix) yang tetap. Penyedia model seperti Anthropic menetapkan kebijakan hemat di mana pembacaan kembali dari cache (disebut cache read) memperoleh diskon 90% atau hanya dikenakan 10% dari tarif dasar token input. Penulisan awal ke cache dikenakan biaya 1,25 kali atau 25% lebih tinggi dengan masa aktif 5 menit, namun investasi ini menguntungkan untuk percakapan panjang. OpenAI juga menerapkan sistem serupa dengan diskon hingga 50% untuk token input di dalam cache.
| Teknik Optimasi | Sasaran Token | Potensi Penghematan | Pertimbangan Kualitas |
| Model Routing | Input dan output | Mengurangi biaya tugas ringan | Memerlukan klasifikasi intent yang akurat |
| Prompt Caching | Token input berulang | Diskon 50% hingga 90% | Memerlukan urutan prefix yang statis |
| Context Compaction | Token riwayat percakapan | Memangkas akumulasi memori | Berisiko kehilangan detail lampau |
Kompresi Riwayat dan Rangkuman Konteks
Tantangan berikutnya muncul ketika sesi interaksi pengguna berlangsung lama, misalnya pada chatbot asisten akademik kampus. Setiap giliran obrolan baru biasanya mengangkut rekaman sebelumnya, sehingga jumlah token input melipatgandakan biaya secara beruntun. Jika dibiarkan tanpa kendali, sesi obrolan panjang akan cepat menguras anggaran tim pengembang hanya demi mengingat percakapan sepuluh menit yang lalu.
Untuk mengatasi akumulasi tersebut, pengembang menerapkan teknik context compaction dan perangkuman bertahap (summarization). Sistem mempertahankan jendela geser (sliding window) untuk pesan terbaru dan merangkum interaksi lawas menjadi poin padat. Pengembang juga memangkas format data berulang seperti JSON agar menjadi representasi ringkas. Gambar 2 mengilustrasikan bagaimana ketiga teknik ini berpadu membentuk arsitektur Token Cost Engineering yang terstruktur.
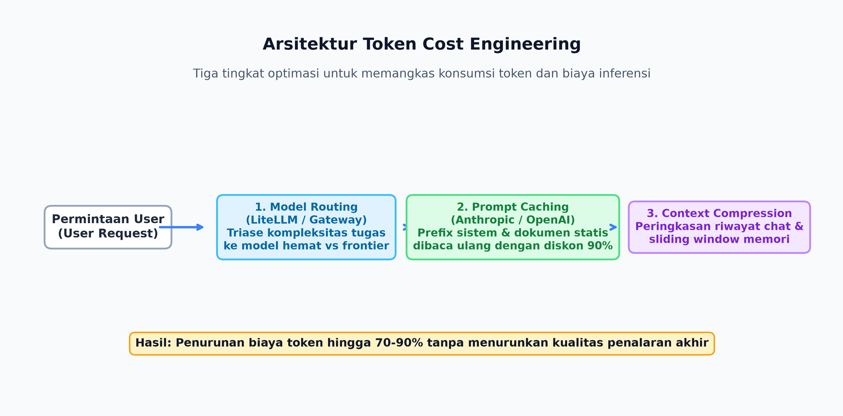 Gambar 2. Tiga pilar arsitektur Token Cost Engineering: model routing, prompt caching, dan kompresi konteks (ilustrasi penulis). (sumber: https://docs.litellm.ai/docs/routing)
Batasan Praktis Token Cost Engineering
Meskipun penghematan biaya merupakan pilar penting, optimasi token tidak boleh dilakukan secara berlebihan. Mengalihkan tugas penalaran kritis ke model murah berisiko memicu halusinasi atau kegagalan eksekusi skrip terstruktur. Selain itu, menyisipkan terlalu banyak lapisan penyaring dan peringkas teks dapat menambah latensi waktu tanggap pertama (time-to-first-token) yang mengurangi kenyamanan pengguna.
Prinsip utama bagi mahasiswa dan perekayasa perangkat lunak adalah mengukur metrik sebelum melakukan perombakan arsitektur. Mulailah dengan mencatat sebaran konsumsi token per fitur, lalu terapkan triase routing dan prompt caching pada titik yang paling boros. Melalui penerapan disiplin Token Cost Engineering, aplikasi cerdas buatan Anda dapat melayani banyak pengguna aktif secara andal dengan pengeluaran yang tetap terkendali.
Referensi
- Anthropic. Prompt Caching: Optimize Your API Usage. https://docs.anthropic.com/en/docs/build-with-claude/prompt-caching
- Cloudflare. Announcing AI Gateway: Making AI Applications More Observable, Reliable, and Scalable. https://blog.cloudflare.com/announcing-ai-gateway/
- LiteLLM. Router: Load Balancing and Fallbacks. https://docs.litellm.ai/docs/routing
- 4. OpenAI. Prompt Caching in OpenAI API. https://platform.openai.com/docs/guides/prompt-caching
Comments :