


Struktur Output AI: Biar Jawaban Chatbot Langsung Jadi JSON
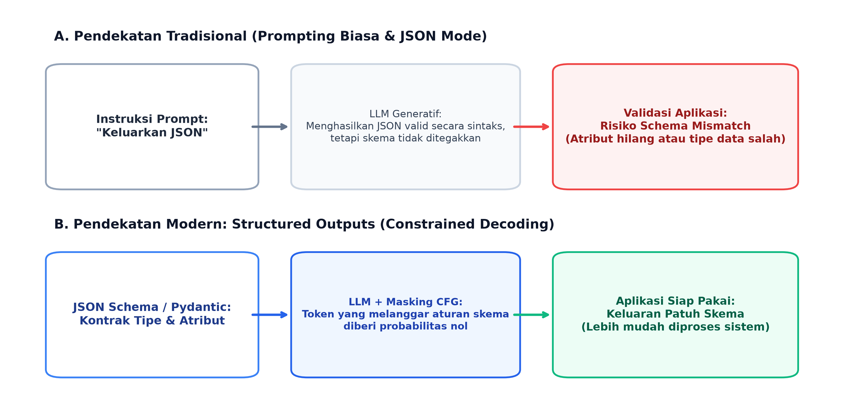 Gambar 1. Alur JSON biasa dibanding constrained decoding pada structured outputs (sumber: https://developers.openai.com/api/docs/guides/structured-outputs)
Pernahkah Anda meminta chatbot menghasilkan JSON, tetapi aplikasi mogok saat membacanya? Model kadang menyisipkan basa-basi sebelum kurung kurawal, lupa menutup tanda kutip, atau melewatkan koma sehingga parser melempar error. Hai, Software Engineers, ini masalah yang akrab bagi siapa pun yang menyambungkan AI ke sistem produksi. Masalah ini muncul karena model bahasa pada dasarnya generator teks, bukan generator struktur data. Output yang tampak seperti JSON belum tentu valid, apalagi patuh pada skema yang diminta aplikasi. Rekayasa perangkat lunak menuntut kontrak data yang kaku karena satu atribut yang hilang bisa menghentikan alur kerja otomatis. Structured outputs menjawab kebutuhan itu dengan mengunci bentuk output sejak token pertama dibuat.
Apa Itu Structured Outputs?
Structured outputs adalah kapabilitas model bahasa untuk memastikan output-nya mematuhi skema pengembang, misalnya JSON Schema. Pengecualiannya hanya dua: respons terpotong batas token atau ditolak demi keamanan. Gagasan generasi terpandu ini dipopulerkan Brandon Willard dan Rémi Louf lewat pendekatan otomata pada proyek Outlines pada 2023. Pada 2024, OpenAI meresmikan fitur Structured Outputs bawaan pada API mereka, dan Google menghadirkan dukungan serupa untuk subset JSON Schema pada Gemini.
Bagaimana Constrained Decoding Bekerja?
Alih-alih membiarkan model menebak kata secara bebas, sistem menerapkan decoding berkendala atau constrained decoding. Mekanisme ini membatasi pilihan token pada setiap langkah sesuai skema yang disiapkan pengembang. Perbedaan alur JSON biasa dan decoding berkendala tampak pada Gambar 1.
Prosesnya berjalan dalam tiga tahap:
- Kompilasi Skema: mengubah JSON Schema menjadi tata bahasa bebas konteks untuk memetakan aturan struktur dokumen.
- Penyaringan Token: memeriksa status tata bahasa pada setiap langkah generasi, lalu memberi probabilitas nol pada token yang melanggar aturan, seperti pada Gambar 2.
Aturan teknisnya berasal dari skema, bukan dari instruksi teks yang bisa diabaikan model. Pembatasan ini mengatur bentuk respons tanpa mengubah maksud pertanyaan pengguna. Hasilnya, struktur output konsisten dengan spesifikasi sejak awal generasi.
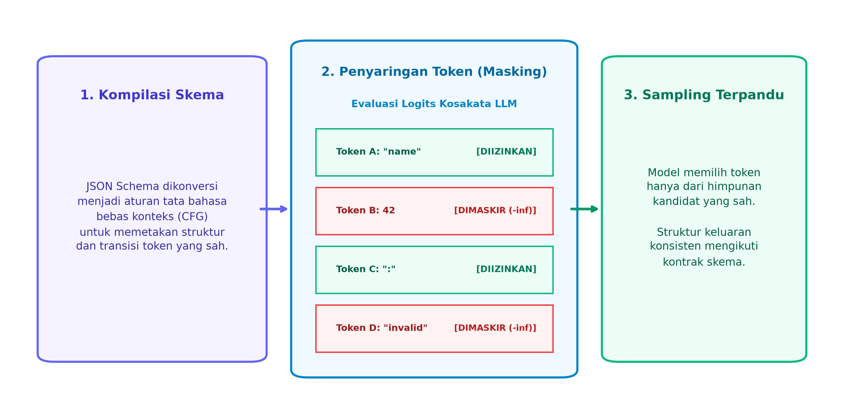 Gambar 2. Mekanisme penyaringan token berbasis tata bahasa pada constrained decoding (sumber: https://developers.openai.com/api/docs/guides/structured-outputs)
Kapan Pola Ini Dipakai di Aplikasi Nyata?
Keandalan struktur data membuka integrasi sistem berskala besar. Penerapan utamanya adalah eksekusi pemanggilan fungsi otomatis pada agen AI, yang memanggil API pihak ketiga dengan risiko parameter hilang yang lebih kecil. Bidang lain meliputi ekstraksi data dokumen ke basis data serta pembentukan antarmuka dinamis. Bedakan validitas struktur dari kebenaran isi: format yang rapi bukan bukti jawabannya benar.
Dari sisi performa, penelitian Dong dkk. (2024) lewat mesin XGrammar menunjukkan kompilasi tata bahasa yang efisien mampu mempercepat penyaringan token hingga 3 kali lipat pada pengujian skema JSON. Inovasi ini diadopsi penyedia infrastruktur inferensi seperti vLLM untuk melayani generasi terstruktur pada skala besar. Dampaknya berbeda menurut skema, model, dan beban yang diuji. Pengembang tetap perlu mengukur kinerja pada alur kerja sendiri. Arsitektur Transformer yang memproses token-token ini tampak pada Gambar 3.
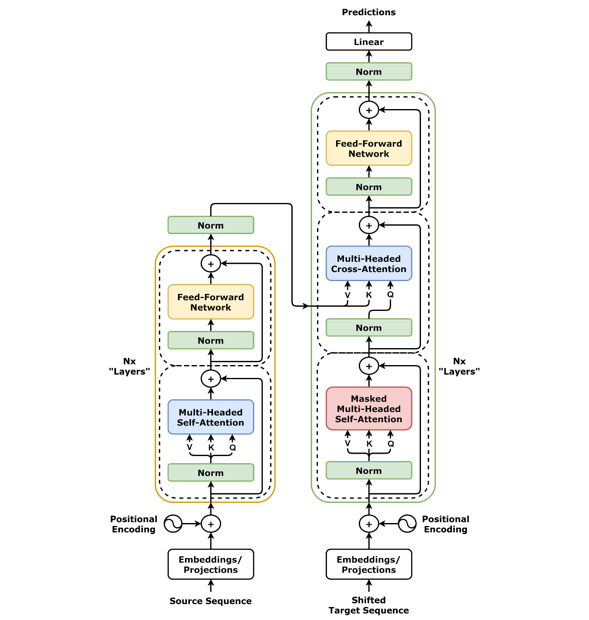 Gambar 3. Arsitektur Transformer dengan mekanisme attention, oleh dvgodoy, CC-BY 4.0 (sumber: https://commons.wikimedia.org/wiki/File:Transformer,_full_architecture.png)

Perbandingan dua pendekatan ini diringkas pada tabel berikut:
| Aspek | JSON Mode Standar | Structured Outputs |
| Jaminan sintaksis | JSON valid | JSON valid dan patuh skema |
| Kelengkapan atribut | Tidak dipaksakan | Mengikuti atribut wajib skema |
| Tipe data nilai | Mengikuti probabilitas model | Dibatasi tipe data skema |
| Mekanisme kerja | Instruksi teks | Pemfilteran token berbasis tata bahasa |
| Validasi | Perlu di kode aplikasi | Tervalidasi saat generasi |
Kelebihan dan Batasnya
Manfaat terbesar pola ini adalah kepastian format dan berkurangnya pengulangan panggilan API akibat format rusak. Namun kompilasi skema butuh komputasi di awal, dan model bisa dipaksa mengisi nilai walau data tidak ada pada konteks. Format yang valid bukan bukti isinya benar, jadi pemeriksaan logika tetap diperlukan. Tangani juga penolakan keamanan dan respons terpotong agar aplikasi tidak menggantung.
Kesimpulan
Tim yang membangun otomasi di atas model bahasa kini punya cara menjaga kontrak data tanpa parser darurat di setiap sudut kode. Structured outputs memisahkan penalaran AI dari ketegasan format, sehingga aplikasi hilir menerima data siap olah. Tentukan sejak awal respons yang aman untuk penolakan dan output terpotong. Dengan begitu, JSON dari chatbot berhenti menjadi sumber kejutan di produksi.
Referensi
- OpenAI. (2024). Structured Outputs Guide. https://developers.openai.com/api/docs/guides/structured-outputs
- Google AI. (2024). Structured Outputs with Gemini API. https://ai.google.dev/gemini-api/docs/structured-output
- Dong, Y., dkk. (2024). XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models. https://arxiv.org/abs/2411.15100
- Willard, B. T., & Louf, R. (2023). Efficient Guided Generation for Large Language Models. https://arxiv.org/abs/2307.09702
- vLLM Team. (2024). Structured Outputs in vLLM. https://docs.vllm.ai/en/latest/features/structured_outputs/
Comments :